L'essentiel en 90 secondes
Extraits des deux démonstrations complètes présentées plus bas, dans l'ordre réel : des questions et leurs graphiques, l'interface en arabe, un projet de prédiction et ses graphiques d'évaluation, puis une base inconnue, une erreur contestée et corrigée, et le rapport final.
Le code de DataBot est privé : les démonstrations, le notebook et le rapport publiés sur cette page en sont la preuve.
Le problème
Les entreprises ont plus de données que de personnes pour les analyser, et les assistants IA génériques donnent des réponses que personne ne peut vérifier. Il manquait un outil qui travaille comme un data scientist, rapidement, mais sous le contrôle d'une personne compétente.
Architecture
Schéma simplifié, dessiné par moi.
Ma démarche
- Un seul agent qui choisit lui-même ses outils : requêtes SQL, code Python, graphiques, rapports, fichiers.
- Un accès en lecture seule aux sources (PostgreSQL, MySQL, SQLite, CSV, Excel, Parquet) : il ne peut jamais modifier les données.
- Une session Python isolée dans Docker, où il écrit et exécute son code et installe les bibliothèques dont il a besoin.
- Les projets de modélisation suivent CRISP-DM : chaque phase produit un rapport (constats, décisions, limites) et ne se clôt que si l'utilisateur l'approuve, la passe ou la renvoie.
- Tout son travail est visible en direct et téléchargeable (notebook .ipynb et PDF).
- Il apprend des retours : un avis négatif commenté devient une leçon qu'il réutilise ensuite.
- Une interface web en français, anglais et arabe, avec comptes, rôles et environ 330 tests automatisés.
Démonstration 1 : prédiction
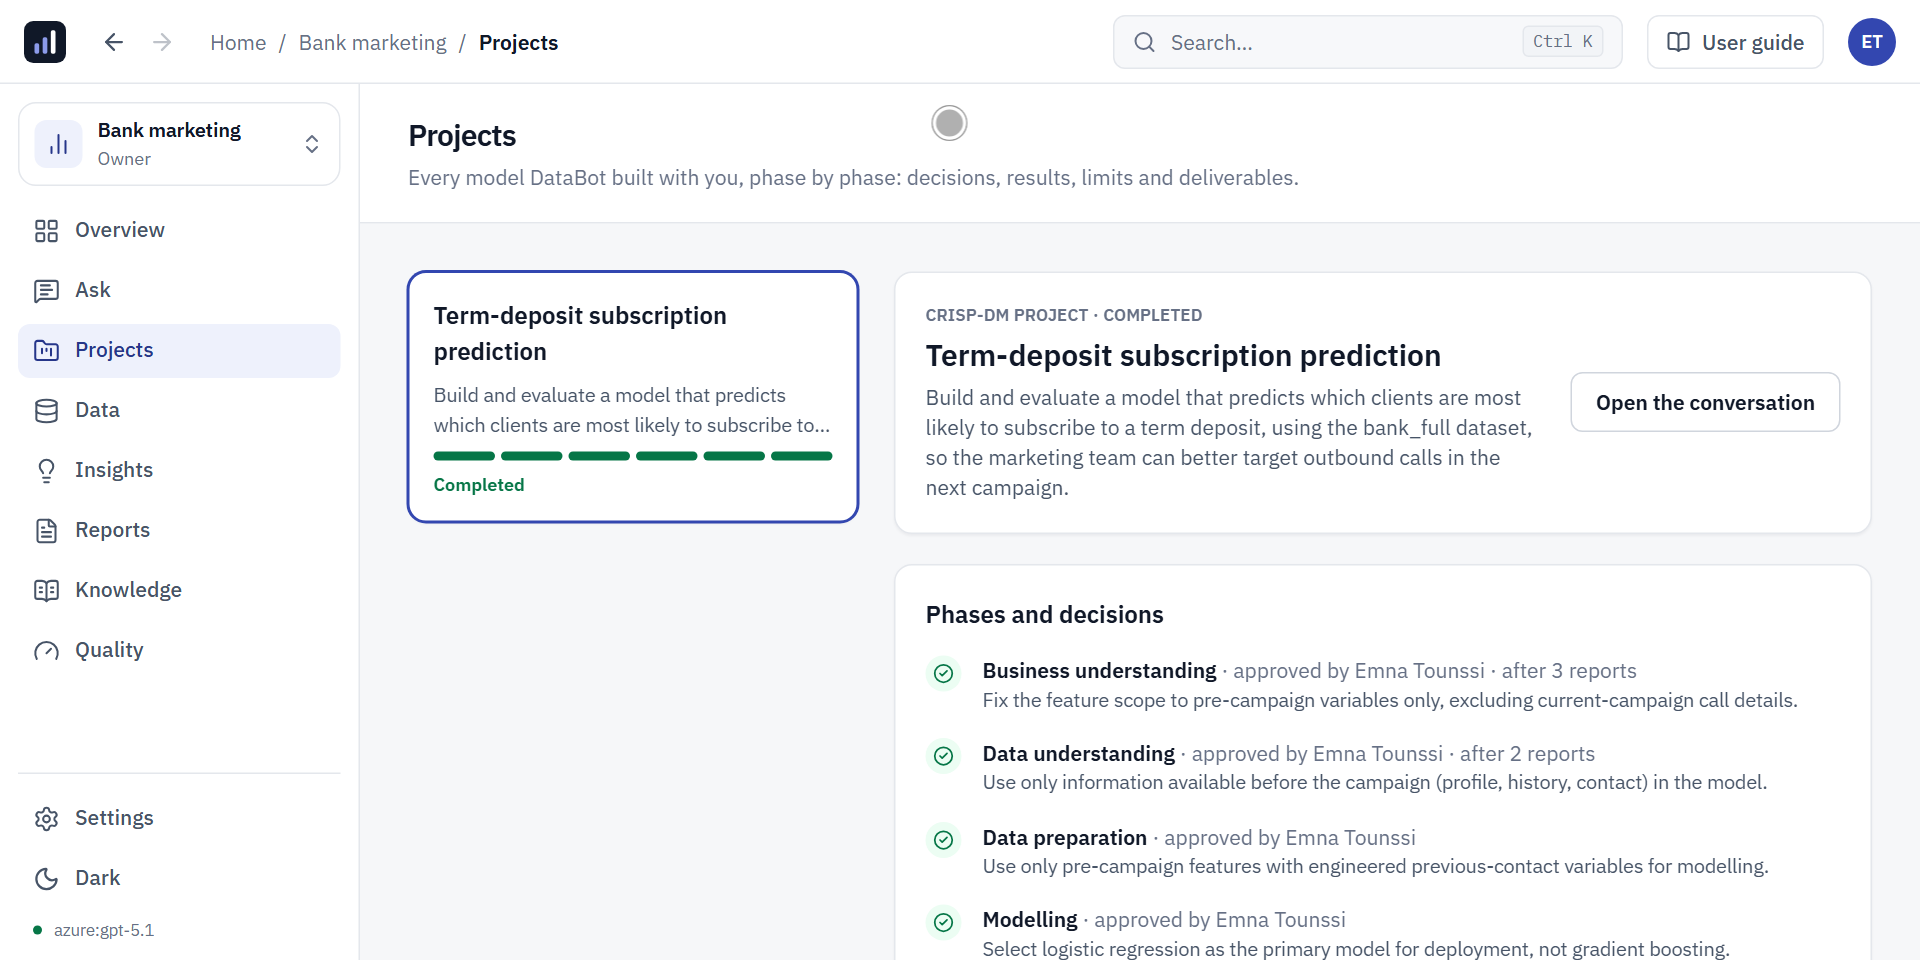
Enregistrement réel de la plateforme : connexion d'une base MySQL et d'un fichier Excel, puis un projet complet de prédiction sur des données bancaires publiques, avec les graphiques d'évaluation.
Résultats de la démonstration 1
- Souscriptions à nombre d'appels égal
- +40 %
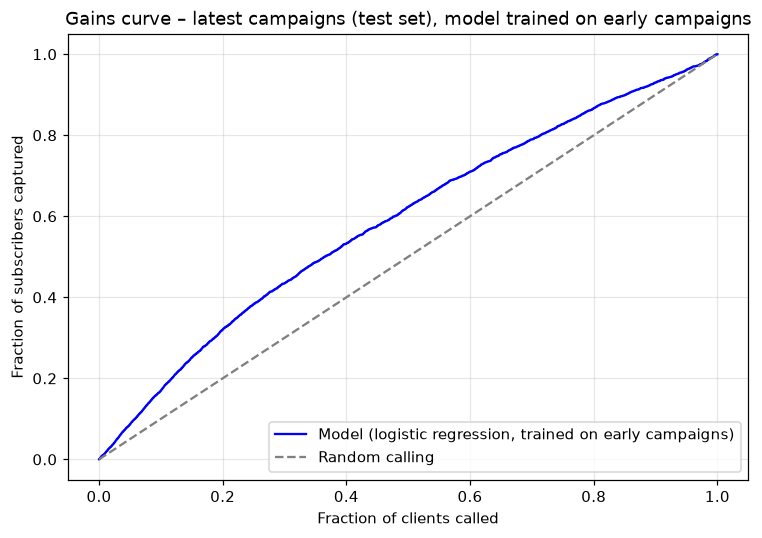
- Des souscripteurs atteints avec un tiers des appels
- 47 %
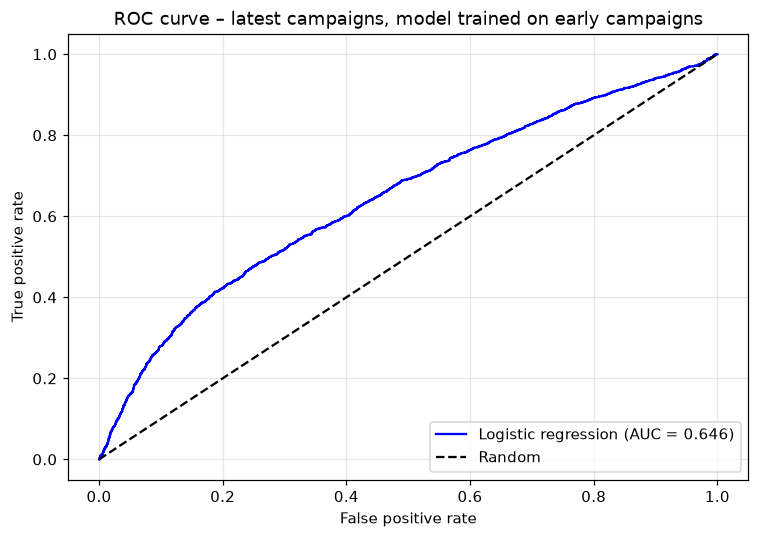
- AUC sur des campagnes non vues
- 0,646
- Tests automatisés
- ≈ 330
Projet de démonstration sur UCI Bank Marketing (45 211 appels, mai 2008 à novembre 2010) : prédire quels clients vont souscrire à un dépôt à terme. Le modèle a été entraîné sur les campagnes les plus anciennes et évalué sur les plus récentes, dans l'ordre réel du temps : en appelant le tiers des clients le mieux classé, on obtient 1 267 souscriptions au lieu d'environ 889 au hasard. Pour situer l'AUC de 0,646 : cette version du jeu de données ne contient pas d'indicateurs économiques, et sur les mêmes données et la même période de test, des modèles de référence (forêt aléatoire, gradient boosting, régression logistique) obtiennent entre 0,64 et 0,67. Les scores plus élevés publiés viennent de conditions plus faciles : un découpage aléatoire qui mélange passé et futur, une version enrichie d'indicateurs macroéconomiques, ou la durée de l'appel, connue seulement après l'appel, que l'agent a repérée et exclue de lui-même.
Deuxième démonstration : autre domaine
Enregistrement réel, dans l'ordre, accéléré seulement pendant que DataBot calcule. Une base PostgreSQL de 9 tables qu'il n'avait jamais vue (Olist, e-commerce brésilien, environ 100 000 commandes), des questions en anglais, une règle métier, puis un projet CRISP-DM sans prédiction : comprendre les mauvais avis, regrouper les plaintes écrites en portugais et segmenter les vendeurs. On y voit aussi DataBot se tromper sur une définition dans son rapport final, puis la corriger dès que je la conteste.
- Mauvais avis si livrée avec plus de 7 jours de retard
- 78 %
- Mauvais avis si livrée à l'heure
- 9 %
- Stabilité des segments de vendeurs (30 relances)
- 0,94
- Réponses vérifiées par moi, sans relance
- 5 / 5
- Les pièges classiques évités seul : vrais clients (96 096, pas 99 441), mois incomplets, avis en double, montants gonflés par les jointures.
- Les commentaires en portugais regroupés en 7 thèmes de plaintes lisibles, validés par un modèle de sujets automatique (NMF).
- Des modèles explicatifs (régression logistique, rapports de cotes), dont la robustesse est vérifiée séparément sur 2017 et 2018.
- Avant l'enregistrement, j'avais calculé et figé moi-même les réponses de référence ; tous les chiffres vérifiés correspondent.
Voir le notebook complet, non retouché · Voir le rapport PDF écrit par DataBot · Télécharger le notebook (.ipynb compressé)
Données : Olist, Brazilian E-Commerce Public Dataset (Kaggle), licence CC BY-NC-SA 4.0. Le notebook et le rapport sont diffusés sous la même licence.
Prêt pour un déploiement public
J'ai préparé DataBot pour qu'il puisse être ouvert à n'importe qui sur internet, sans que le serveur paie l'IA de ses utilisateurs ni prenne de risque avec le code qu'ils font exécuter.
- Comptes ouverts. Inscription libre, confirmée par un code envoyé par e-mail ; chacun peut exporter ou supprimer toutes ses données à tout moment.
- Chacun sa clé IA. OpenAI, Anthropic, Google, Azure, Groq ou OpenRouter : la clé est testée avant d'être acceptée, stockée chiffrée et jamais réaffichée. Le serveur n'utilise jamais de clé à lui : sans clé valide, pas d'espace de travail.
- Code isolé. Chaque conversation exécute son code Python dans son propre conteneur, sans internet ni privilèges, avec des limites de mémoire, de temps et de processus, et une file d'attente quand le serveur est occupé.
- Connexions protégées. Une base de données n'est acceptée que si elle se trouve sur internet : les adresses internes du serveur sont refusées avant toute connexion.
- Prouvé par des tests. Environ 70 tests dédiés, dont de vraies attaques lancées depuis l'intérieur d'un conteneur (réseau, fichiers des autres utilisateurs, élévation de privilèges, bombe de processus) : toutes bloquées.
Prêt à déployer (configuration du serveur, HTTPS et guide inclus), mais pas encore hébergé publiquement, faute de budget d'hébergement. Démonstration en direct sur demande.
Limites
DataBot est conçu pour assister un data scientist, pas pour le remplacer : c'est la supervision qui fait sa force. Pendant la démonstration, certaines étapes ont été challengées, notamment la validation dans l'ordre réel du temps et un premier fichier de modèle à corriger ; chaque fois, la phase est restée ouverte jusqu'à la correction.
Dans la démonstration 2, après un résumé automatique de la longue conversation, il a d'abord compté le retard en jours entiers dans le rapport final, au lieu de la règle métier ; il l'a reconnu et corrigé dès que je l'ai relevé. Les définitions décidées pendant un projet devront être conservées hors du résumé.
La qualité de son travail dépend aussi du modèle de langage utilisé.
Aucune isolation n'est parfaite : sur un serveur public, il faudra garder le système et Docker à jour, et n'y héberger rien d'autre d'important.